Durante os últimos anos, produtividade com IA se resumia a uma pergunta: qual é o melhor modelo?
Em 2026, essa pergunta ficou cara. E, pior, ficou errada.
Os navegadores portugueses batizaram a ponta sul da África de Cabo das Tormentas. Só depois de aprenderem a atravessá-la com rota, preparo e disciplina, alguém teve coragem de rebatizá-la de Cabo da Boa Esperança.
Em Os Lusíadas, Camões colocou um gigante ali, o Adamastor, pra lembrar que a tempestade não se vence no tamanho do navio.
Com IA está acontecendo o mesmo. O gargalo saiu da inteligência do modelo, a nau maior, o motor mais forte, e foi parar na engenharia ao redor dele: a rota, o preparo, a disciplina de quem atravessa.
E nenhum modelo novo, por melhor que seja, vai te salvar disso.
Casa de ferreiro, espeto de pau
Quando uma empresa de IA não consegue controlar a escalada de custos dentro de casa, você sabe que temos um problema.
OpenAI publicou um post no último dia 6/set [1] explicando como seus pesquisadores têm aumentado o uso de IA em suas pesquisas e, por consequência, seus custos.
Researchers are using coding agents throughout the day (often in concurrent sessions) and total usage is rapidly increasing, outpacing growth among other OpenAI teams.
OpenAI [1]
Eles chamam isso de automated AI research.
Como uma imagem vale mais do que mil palavras, observe o problema:
Pra ficar claro: pesquisadores medianos consumindo mais de US$600/dia em inference no fim de agosto (vs. ~US$150 meses antes);
Dado a aceleração em julho, meu palpite é que os pesquisadores tiveram acesso a um modelo de fronteira (Astra?) e que, com isso, o custo deles explodiu.
Eu sei, você pode argumentar que eles estão atrás da AGI (que já chamam de Recursive Self-improvement, RSI) e que, portanto, o pioneirismo tem seu preço.
E que preço.
Eles também publicaram um número interessante: o crescimento no número de experimentos ativos que cada pesquisador tem trabalhado:
Sem dúvidas, um crescimento importante. Agora vamos colocar em escala, em relação ao primeiro chart, o de custos:
Mas mesmo assim, como diria Warren Buffett: “Preço é o que você paga, valor é o que você tem”.
A virada: o modelo deixou de ser a resposta
Se nem quem fabrica os modelos controla o custo de usá-los, a saída parou de ser “esperar o próximo modelo”. O modelo intermediário de hoje foi o modelo de fronteira ontem. E seus custos também.
O gargalo da engenharia de software com IA está deixando de ser inteligência e passando a ser arquitetura de workflow no processo de desenvolvimento.
The gap between what today’s models can do and what you see them doing is largely a harness gap.
Addy Osmani [5]
O caminho para a balança entre custo vs qualidade, na minha mente, passa pela escolha inteligente de modelos + um bom harness.
Deixe a máquina escolher a máquina
Você poderia argumentar: “então é só o dev escolher o modelo barato quando dá.”
Na prática, isso não escala. Cada decisão de “qual modelo agora?” é uma troca de tarefa. E troca de tarefa tem custo mensurável de tempo e erro.
O dev que fica micro-otimizando modelo para economizar centavos de inference está gastando o recurso mais caro da sala: a própria atenção. É falsa economia. Não é trabalho de humano. É trabalho que precisa ser automatizado.
Como resposta disso, há um crescimento nos mecanismos de escolha inteligente de modelos, que tentam identificar dinamicamente a natureza e a complexidade das tarefas e, assim, escolher o modelo que forneça a melhor qualidade com o menor preço.
Algumas opções:
Nesta última semana, tenho testado o Copilot HydraFusion [2]. Embora ainda experimental, os resultados têm sido satisfatórios: bons outputs, custo razoável.
Em vez de o desenvolvedor escolher simplesmente “o melhor modelo”, o runtime decide entre os padrões single, cascade e critique, combinando modelos diferentes conforme o problema.
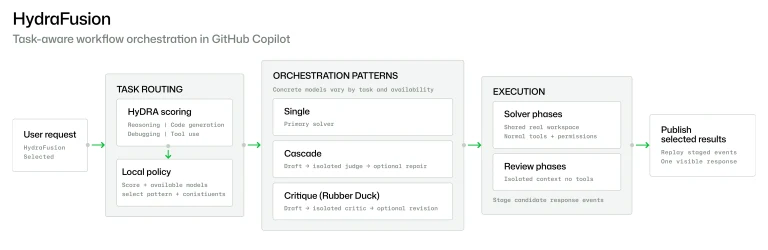
Nos testes deles, houve uma redução de mais de 60% do custo, se comparado ao uso contínuo do Opus 5. No meu uso limitado durante testes, estimo uma economia mais tímida, algo entre 20 a 30%.
Porém, há um aumento de latência nos prompts, dado que a orquestração adaptativa tem seu preço: o tempo de decisão agora aparece em cada execução.
Antes
- Problema
- Escolher modelo
- Prompt
- Resposta
Agora
- Problema
- Classificação
-
Workflow
- modelo barato
- modelo forte
- paralelo
- crítico
- memória
- ferramentas
- retry
- sandbox
- verificação
- Resultado
Harness: foco no ambiente, não o modelo
Harness não é só confiabilidade. Um agente trabalhando de forma errada significa tokens queimados, retrabalho e tempo de review. Disciplina aqui gera economia.
Harness
Contexto
Prompt
Um bom harness constrói o ambiente no qual o agente consegue executar trabalho confiável.
Isso não elimina todos os problemas, mas cria um processo.
A decent model with a great harness beats a great model with a bad harness.
Addy Osmani [5]
O caso Codex
Para além da definição formal, a OpenAI publicou um excelente artigo sobre a construção de um time agêntico (agent-only) e documentou o processo em seu post “Harness engineering: leveraging Codex in an agent-first world” [4].
O mais importante é a sinceridade deles ao admitir: no início, o processo é mais lento.
Early progress was slower than we expected
OpenAI [4]
E, na minha percepção nos meus times, isso é verdade, em especial em projetos criados antes desta era de IA e agentes.
Contexto, guardrails, quality gates, intenções de entrega, padrões de codificação, design, processo de review, testes… definir isso tudo leva tempo.
No fim, eles construíram uma miríade de .mds contendo todo o harness necessário para a aplicação:
AGENTS.md
ARCHITECTURE.md
docs/
├── design-docs/
│   ├── index.md
│   ├── core-beliefs.md
│   └── ...
├── exec-plans/
│   ├── active/
│   ├── completed/
│   └── tech-debt-tracker.md
├── generated/
│   └── db-schema.md
├── product-specs/
│   ├── index.md
│   ├── new-user-onboarding.md
│   └── ...
├── references/
│   ├── design-system-reference-llms.txt
│   ├── nixpacks-llms.txt
│   ├── uv-llms.txt
│   └── ...
├── DESIGN.md
├── FRONTEND.md
├── PLANS.md
├── PRODUCT_SENSE.md
├── QUALITY_SCORE.md
├── RELIABILITY.md
└── SECURITY.md
É importante lembrar que nem todos os projetos precisam de tantas especificações. O padrão deles não deve ser automaticamente o seu. Nem o meu.
E o humano, onde entra?
Não é “simplesmente codar”, com certeza. Até mesmo o processo de review de Merge/Pull Requests, segundo a OpenAI, ficou menos “exclusivo” aos humanos.
O humano continua no loop. Não por empatia, mas por necessidade. Deixar tudo na mão dos agentes traz um mundo de novos problemas.
We're still learning where human judgment adds the most leverage and how to encode that judgment so it compounds.
(…)
Our most difficult challenges now center on designing environments, feedback loops, and control systems that help agents accomplish our goal: build and maintain complex, reliable software at scale.
OpenAI [4]
O diferencial mudou de lugar
Voltemos ao começo.
Nem a OpenAI, que fabrica os modelos, consegue evitar a escalada dos custos. Esperar o próximo resolver isso é ingenuidade. O modelo deixou de ser o gargalo, o ambiente em volta dele é que é.
Routing decide qual modelo roda, harness decide em que condições, duas faces da mesma disciplina que morde mais forte em bases de código grandes e antigas, onde legado cobra harness.
A vantagem competitiva parou de ser acesso ao melhor modelo, isso todo mundo com algum dinheiro (e pouco juízo) tem. Passou a ser a capacidade de construir o melhor ambiente pro agente trabalhar.
Modelo virou commodity, workflow virou o diferencial.